
RFC1928:SOCK5
SOCKS是一种网络传输协议,主要用于客户端与外网服务器之间通讯的中间传递。当防火墙后的客户端要访问外部的服务器时,就跟SOCKS代理服务器连接。这个代理服务器控制客户端访问外网的资格,允许的话,就将客户端的请求发往外部的服务器。根据OSI模型,SOCKS是会话层的协议,位于表示层与传输层之间。

SOCKS是一种网络传输协议,主要用于客户端与外网服务器之间通讯的中间传递。当防火墙后的客户端要访问外部的服务器时,就跟SOCKS代理服务器连接。这个代理服务器控制客户端访问外网的资格,允许的话,就将客户端的请求发往外部的服务器。根据OSI模型,SOCKS是会话层的协议,位于表示层与传输层之间。

aaa,bbb,ccc CRLF
zzz,yyy,xxx CRLFaaa,bbb,ccc CRLF
zzz,yyy,xxxfield_name,field_name,field_name CRLF
aaa,bbb,ccc CRLF
zzz,yyy,xxx CRLF,号分隔,最后一个字段记录后面不能有分隔符。例如:AAA,BBB,CCC"aaa","bbb","ccc"CRLF
ZZZ,YYY,XXX"aaa","b CRLFbb","ccc" CRLF
zzz,yyy,xxx"aaa","b""bb","ccc"file = [header CRLF] record *(CRLF record) [CRLF]
header = name *(COMMA name)
record = field *(COMMA field)
name = field
field = (escaped / non-escaped)
escaped = DQUOTE *(TEXTDATA / COMMA / CR / LF / 2DQUOTE) DQUOTE
non-escaped = *TEXTDATA
COMMA = %x2C
CR = %x0D ;as per section 6.1 of RFC 2234 [2]
DQUOTE = %x22 ;as per section 6.1 of RFC 2234 [2]
LF = %x0A ;as per section 6.1 of RFC 2234 [2]
CRLF = CR LF ;as per section 6.1 of RFC 2234 [2]
TEXTDATA = %x20-21 / %x23-2B / %x2D-7E
本文介绍如何批量执行 mysql 语句。
尝试复现问题
CREATE SCHEMA `tmp` DEFAULT CHARACTER SET utf8 COLLATE utf8_danish_ci ;
flush privileges;
grant all privileges on tmp.* to 'victorchu'@'localhost' ;CREATE TABLE IF NOT EXISTS `tmp`.`A`(
`id` INT NOT NULL,
`name` VARCHAR(45) NULL,
`b_name` VARCHAR(45) NULL,
PRIMARY KEY (`id`))
ENGINE = InnoDB
DEFAULT CHARACTER SET = utf8;
INSERT INTO `tmp`.`A` (`id`, `name`, `b_name`) VALUES ('1', '1', '1');
INSERT INTO `tmp`.`A` (`id`, `name`, `b_name`) VALUES ('2', '2', '2');
INSERT INTO `tmp`.`A` (`id`, `name`, `b_name`) VALUES ('3', '3', '3');接着创建表B。
MySQL提供的group_concat()函数可以拼接某个字段值成字符串,如 select group_concat(user_name) from sys_user,默认的分隔符是逗号,即,,如果需要自定义分隔符可以使用 SEPARATOR.如:select group_concat(user_name SEPARATOR '_') from sys_user。
java命令用于启动JVM虚拟机。Java启动参数分为3种:
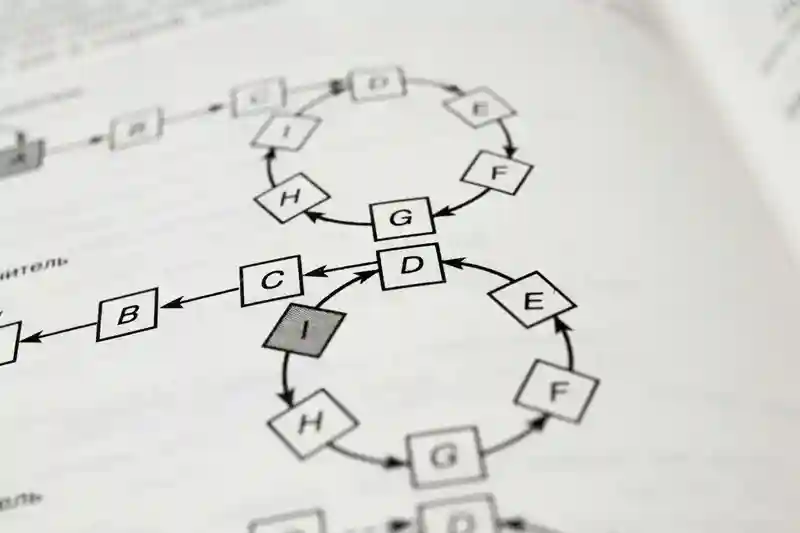
有一个文本串S,和一个模式串P,现在要查找P在S中的位置,怎么查找呢?
假设主串target为: a b a c a a b a c a b a c a b a a b b,模式串pattern: a b a c a b(为了方便查看,每个字符间用空格隔开)。
用暴力算法匹配字符串过程中,我们会把target[0]跟 pattern[0] 匹配,如果相同则匹配下一个字符,直到出现不相同的情况,此时我们会丢弃前面的匹配信息,然后把target[1]跟 pattern[0] 匹配,循环进行,直到主串结束,或者出现匹配成功的情况。这种丢弃前面的匹配信息的方法,极大地降低了匹配效率。
以上面的字符为例子:pattern的前5个字符abaca可以匹配target的前5个字符,但是pattern[5]和target[5]不匹配。下面重新从target[1]开始和pattern匹配。
显然效率很差,因为你要把"搜索位置"移到已经比较过的位置,重比一遍。
上下文无关的组成部分:
例如,下面数学表达式:
$$ expr \to expr+term $$
$$ expr \to expr-term $$
$$ expr \to term $$
$$ term \to term * factor $$
$$ term \to term/factor $$
$$ term \to factor $$
$$ factor \to (expr) $$
$$ factor \to id $$
+,-。google 提出了 Jump consistent hash 算法,跳转一致性哈希不需要存储,速度更快,并且在均匀划分key方面做得更好。它的主要限制是桶必须按顺序编号,这使得它 比分布式 Web 缓存更适合数据存储应用程序
哈希环法是最常用的、最经典的一致性哈希算法, 也叫做割环法。 这个算法易于理解、应用广泛(例如亚马逊的Dynamo1), 实现了最小化的重新映射。
一致性哈希算法是一种特殊的哈希算法, 当目标槽位数量发生变化时,它会尽力降低的重新映射的数量。 传统的哈希表设计中,添加或者删除一个槽位,会造成全量的重新映射, 一致性哈希则追求的是增量式重新映射。
散列技术是在记录的存储位置和它的关键字之间建立一个确定的对应关系f,使得每个关键字key对应一个存储位置f(key)。査找时,根据这个确定的对应关系找到给定值key的映射f(key),若査找集合中存在这个记录,则必定在f(key)的位置上。
我们把这种对应关系f称为散列函数,又称为哈希(Hash)函数。按这个思想,采用散列技术将记录存储在一块连续的存储空间中,这块连续存储空间称为散列表或哈希表(Hashtable)。那么关键字对应的记录存储位置我们称为散列地址。
给定一个字符串 s,找到 s 中最长的回文子串?
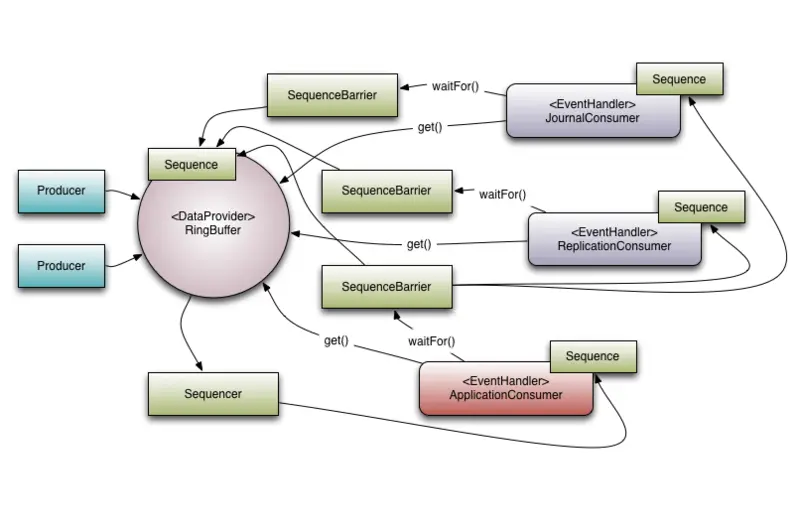
LMAX Disruptor是一个高性能的线程间消息库。下面是其简单架构示意图

之前把ubuntu装到了ssd上,速度变得快了很多。顺手就安装了steam,昨天突然发现磁盘接近满了🤣。立马插上了一块新买的ssd。
Ubuntu + window双系统,删除window后,在grub和bios的EFI启动项中残留WindowBootManager。
单纯修改/boot/grub下的菜单配置,在执行sudo upgrade-grub2后启动项又会恢复WindowBootManager.
1000瓶药水,1瓶有毒药,服用后一小时毒发,毒药可以无限稀释,那么一小时内用几只小白鼠能够找出毒药1?
一只老鼠的状态是2种生或死,这里可以看做bit位,而1000瓶药水有1000种情况,显然我们可以使用2^10 = 1024>1000 来描述这1000种可能,而2进制数的唯一性可以唯一确定一种情况。
bitmap适用于什么场景?
bitmap的核心思想是将一个元素的可能取值映射为某个空间内的值(常见的是1bit空间,提供0,1两种状态。或是2bit空间,提供 0,1,2,3四种状态)。通过某种顺序的映射表来节省存储空间。
tmpwatch 会在指定目录中递归删除指定时间段内未被访问的文件。通常,它用于自动清除临时文件系统目录,例如 /tmp 和 /var/tmp。
lost+found 目录。tmpwatch 会根据文件的 atime(访问时间)而不是 mtime(修改时间)删除文件。tmpwatch 命令中添加其他参数来更改这些行为。警告: 不要在
/中运行tmpwatch或tmpreaper,因为该程序中没有防止这种情况的机制。