
MacOS容器从Docker Desktop到Colima
Colima 轻量、开源、免费 —— 在 Mac 上运行容器的最佳选择

Colima 轻量、开源、免费 —— 在 Mac 上运行容器的最佳选择
git worktree 命令支持管理同一个 git 仓库的多个工作区1,每个工作区可检出不同分支/提交。每个工作区都像一个“轻量级的独立仓库”,但它们共享底层对象库,减少磁盘占用并加速切换。
同一分支在同一时刻只能在一个 worktree 中被检出。如果想在多个 worktree 同时基于同一分支进行试验,需要使用不同分支名,或者使用--detach直接检出到某个提交。
注意,
--detach会产生分离式 HEAD,后续的修改会丢失,一般不推荐使用,除非是仅看用于查看代码。
最近完成了博客从 Hexo 到 Hugo 的迁移,这篇文章记录了迁移的完整历程,包括技术选型、具体实施步骤、遇到的问题以及解决方案。
本文主要介绍Calcite 中的AST转执行计划。关系代数最早由E. F. Codd在1970年的论文A Relational Model of Data for Large Shared Data Banks中提出, 是关系型数据库查询语言的基础, 也是查询优化技术的理论基础。 在Calcite内部, 会将SQL查询转化为一颗等价的关系算子树, 并在此基础上进行查询优化. 通用的关系代数理论可以参考之前的文章形式化关系查询语言, 接下来介绍在Calciate中的实现。
本文主要介绍Calcite 中的SQL Validator。Calcite 通过 SQL 校验器实现 SQL 绑定,SQL 校验器所需的 Catalog 信息,在深入理解 Apache Calcite Catalog 中已经做了详细的介绍。
SQL 绑定主要的作用是将 SQL 解析生成的 AST 和数据库的元数据进行绑定,从而生成具有语义的 AST。SQL 绑定会通过自底向上的方式遍历 AST,对抽象语法树中的节点进行绑定分析,绑定的过程中会将表、列等元数据附在语法树上,最后生成具有语义的语法树 Bounded AST。
Calcite 中的SQL Parser 使用JavaCC 实现。JavaCC 在前面的博客中有过介绍, 本文就不赘述了。本文主要介绍Parser。
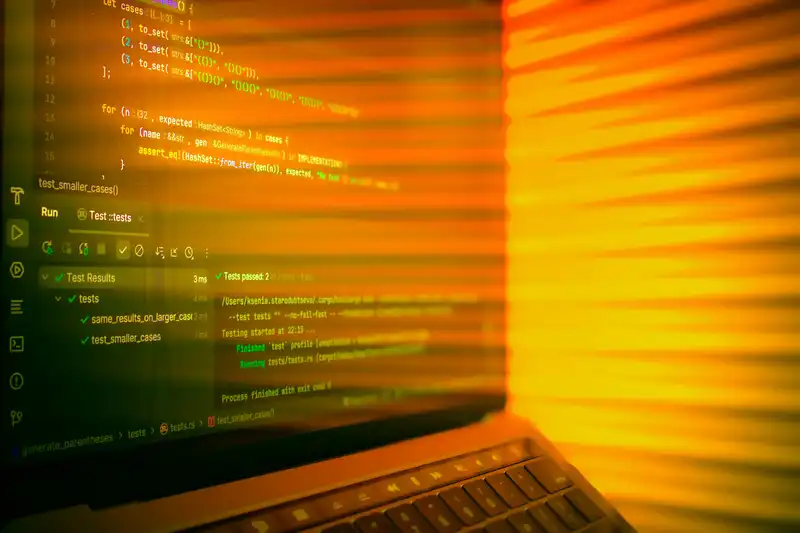
JavaCC的词法解析被转化为一组词法状态,每个状态都有一个唯一的标识符用于命名。Token Manager(生成的代码)在运行时总是处于状态之一,默认的一个词法状态是DEFAULT。当Token Manager初始化时,默认情况下是以DEFAULT状态开始。也可以在Token Manager 构造时,指定起始词法状态1。
上一篇文章我们简单介绍了 JavaCC的语法和使用。本文将以实现一个计算器为例,介绍JavaCC 在实际代码中的使用。
JavaCC 是 java 生态中常用的Parser Generator。特征如下:
JavaCC的工作流程如下:
假设我有两个 github 账号,victor(for personal) 和 superman(for work)。如果我想在同一台电脑上使用这两个账号进行 git push/pull。该如何配置?
当你把一个 Spark 应用交给数据平台服务化时,很快会遇到三个现实问题:客户端机器不一定能直连集群;spark-submit 不适合由 Web 后端反复执行;多个用户的长任务、权限、日志和资源也不能只靠脚本管理。Apache Livy 要解决的就是这一层问题:它把 Spark 集群包装成可远程访问、可管理、可多租户使用的 REST 服务。
这篇文章面向已经了解 Spark Driver、Executor 和 Cluster Manager 的读者。读完你可以理解 Livy Server 的职责边界、Interactive Session 与 Batch Session 的差异、RSC 的连接建立过程、Executor 资源如何分配和扩缩容、Session 状态恢复机制,以及 Livy 与 Spark Connect 的适用边界。
如何在 Rust 的多线程中共享值?
ArcMutex当数据量超过单机内存和 CPU 的处理能力时,很多熟悉的批处理程序会遇到同一个问题:逻辑不难,但很难高效地拆到多台机器上运行。Spark 要解决的正是这件事。它把分布式存储上的数据抽象成可并行操作的数据集,把用户代码转换成可以在集群中调度的任务,同时提供 SQL、流处理、机器学习等统一 API。
Rust 既支持了基于系统线程的多线程编程模型,也支持了基于async/await的异步编程模型。Rust 的async编程有有以下特性:
本文将介绍如果基于 vscode 搭建 Rust 开发环境。
先来看一段 Java 代码,Application中有version和 logger。logger 依赖了 Version。
public class Application
{
    public Version version;
    public Logger logger;
    public Application() {
        version = new Version(1);
        logger =  new Logger(version);
    }

    public static void main(String[] args)
    {
        Application application = new Application();
        application.logger.log("Hello World!");
        // console output:
        // [version 1] Hello World!
    }
    class Version {
        public int ver;
        public Version (int ver){
            this.ver = ver;
        }
        public String toString() {
            return String.format("version %d",ver);
        }
    }
    class Logger {
        public Version version;
        public Logger (Version version){
            this.version = version;
        }
        void log(String msg) {
            System.out.println(String.format("[%s] %s",version,msg));
        }
    }
}
那么问题来了,如何在 Rust 中实现相同的代码?
生命周期,简而言之就是引用的有效作用域。在大多数时候,我们无需手动的声明生命周期,因为编译器可以自动进行推导。当多个生命周期存在,且编译器无法推导出某个引用的生命周期时,就需要我们手动标明生命周期。
生命周期的主要作用是避免悬垂引用,它会导致程序引用了本不该引用的数据:
{
    let r;
    {
        let x = 5;
        r = &x;
    }    // ^^ borrowed value does not live long enough
    println!("r: {}", r);
}
此处 r 就是一个悬垂指针,它引用了提前被释放的变量 x。
为了保证 Rust 的所有权和借用的正确性,Rust 使用了一个借用检查器(Borrow checker),来检查我们程序的借用正确性:
{
    let r;                // ---------+-- 'a
                          //          |
    {                     //          |
        let x = 5;        // -+-- 'b  |
        r = &x;           //  |       |
    }                     // -+       |
                          //          |
    println!("r: {}", r); //          |
}                         // ---------+
r 变量被赋予了生命周期 ‘a,x 被赋予了生命周期 ‘b,从图示上可以明显看出生命周期 ‘b 比 ‘a 小很多。在编译期,Rust 会比较两个变量的生命周期,结果发现 r 明明拥有生命周期 ‘a,但是却引用了一个小得多的生命周期 ‘b,在这种情况下,编译器会认为我们的程序存在风险,因此拒绝运行。如果想要编译通过,也很简单,只要 ‘b 比 ‘a 大就好。总之,x 变量只要比 r 活得久,那么 r 就能随意引用 x 且不会存在危险:
{
    let x = 5;            // ----------+-- 'b
                          //           |
    let r = &x;           // --+-- 'a  |
                          //   |       |
    println!("r: {}", r); //   |       |
                          // --+       |
}                         // ----------+
TCP协议是一种面向连接的有状态网络协议。对于发送的每个数据包,一旦TCP堆栈收到特定数据包的ACK,它就认为它已成功传递。
TCP使用指数退避超时重传一个未确认的数据包,最多tcp_retries2时间(默认为15),每次重传超时在TCP_RTO_MIN(200毫秒)和TCP_RTO_MAX(120秒)之间。一旦第15次重试到期(默认情况下),TCP堆栈将通知上面的层(即应用程序)断开连接。
上篇博客介绍了 CPU异常分析的工具和方法。本文将介绍如何定位 CPU 耗时。